事務・バックオフィスを整理する / 2026年9月30日
「誰かが見ている」を前提にしない|AIでシステム異常を早期検知する3段階
人が画面を見張り続けるのは、そもそも無理な働き方です。監視を人からAIに渡すだけで問題の大部分は解消でき、しかもいま契約しているクラウドにその機能が眠っていることも少なくありません。無料枠から始められる3段階で整理します。
夜間・休日の障害に、人の目だけでは気づけない
サーバーが落ちていた、ネットワーク機器が応答しなくなっていた、基幹システムの処理が止まっていた——気づいたのは翌朝、あるいはお客様からの連絡だった。中小企業の情報システム担当は、専任が1人か兼任というケースが多く、夜間・休日はほぼ無人で監視できていないのが実情です。
異常の検知が遅れるほど、被害は積み上がります。ECサイトが止まっていた時間だけ売上機会を失い、業務システムが止まっていた時間だけ社内の作業が止まる。原因は「監視の仕組みがない」というより、「人が画面を見張り続けることが、そもそも無理な働き方だから」です。
裏を返せば、監視を人からAIに渡すだけで、この問題の大部分は解消できます。しかも、いま契約しているクラウドサービスに、すでにその機能が含まれていることも少なくありません。
自分でやるなら:無理なく始められる監視の3段階
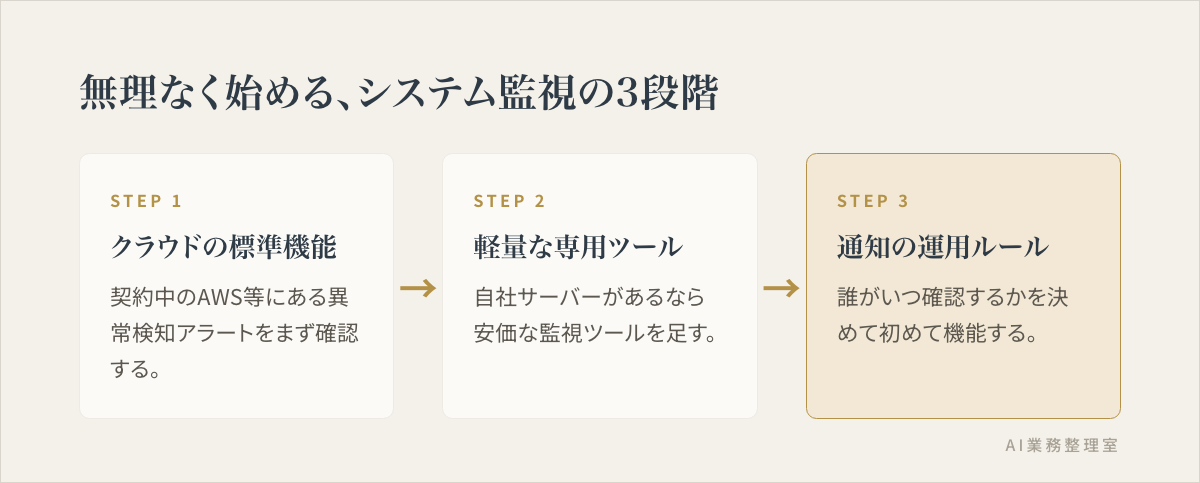
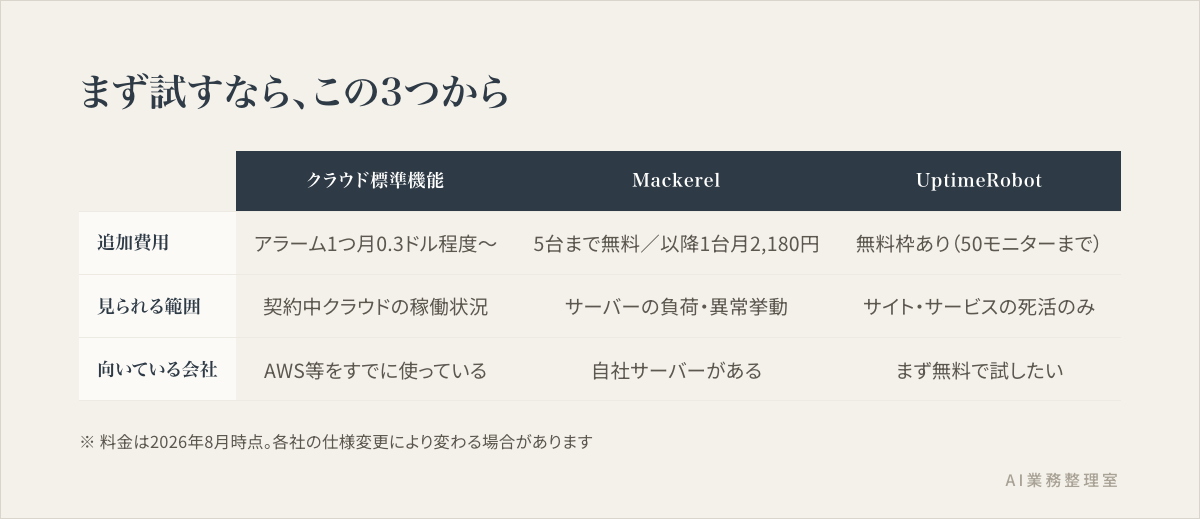
先に、この記事で扱う3つの選択肢を並べておきます。
ステップ1:いま使っているクラウドの「異常検知」機能をまず確認する
AWS・Google Cloud・Azureなど、すでにクラウドを使っているなら、新しいツールを契約する前に、その中にある監視機能を確認します。
たとえばAWSには「CloudWatch」という監視サービスがあり、通常のしきい値アラートに加えて、AIが過去のパターンから「いつもと違う動き」を検知する「Anomaly Detection(異常検知)」という機能があります。無条件で無料というわけではなく、アラーム1つあたり月0.30ドル程度の従量課金ですが、新しいツールを一から契約するより費用も設定の手間も小さく済みます(2026年8月時点、AWS公式サイトより)。
Google CloudやAzureにも同様の監視・アラート機能があるので、まずは契約中のクラウドの管理画面で「モニタリング」「アラート」の項目を確認するのが最初の一歩です。
ステップ2:自社サーバーや自社サイトの監視は、軽量な専用ツールを足す
クラウドだけでなく自社に物理サーバーやネットワーク機器がある場合は、専用の監視ツールが必要になります。ここでDatadog・New Relicのような多機能プラットフォームをいきなり選ぶと、インフラ監視だけで1台あたり月15〜27ドル、ログやAPM機能を足すとさらに別課金が積み重なり、専任の運用担当がいない会社では費用の見通しが立てにくくなります(2026年8月時点、各社公式サイトより)。
中小企業には、日本語対応で料金がシンプルな「Mackerel」(株式会社はてな)が向いています。5台までは無料で使え、有料プランはスタンダードホスト1台あたり月2,180円(税込)です。AIによる異常検知機能(役割ごとにいつもと違う挙動を検知する「ロール内異常検知」)も搭載していますが、これは有料オプション扱いです(2026年8月時点、Mackerel公式サイトより)。まずは無料枠で主要なサーバーを登録し、必要に応じて有料プラン・異常検知機能を足していく進め方が現実的です。
サーバーの中身までは見なくてよく、自社サイトやオンラインサービスが正常に表示されるかどうかだけを確認したい場合は、UptimeRobotのような外形監視サービスが手軽です。無料プランでも50件のモニターを5分間隔でチェックでき、落ちていればメールなどで通知が届きます(2026年8月時点、公式サイトより)。サーバー内部のCPU・メモリなどまでは見られませんが、「サイトが表示されているか」だけならこれで十分なことも多く、まず無料で試すハードルの低さが利点です。
(各ツールの機能・料金は変更になる場合があります。最新情報は各社の公式サイトでご確認ください)
ステップ3:通知を「誰が・いつ確認するか」まで決めて運用に落とす
監視ツールを入れても、アラートが鳴りっぱなしで誰も見ていなければ意味がありません。「誰のスマホに通知するか」「夜間・休日は誰が一次対応するか」「翌営業日でよい異常と、即対応が必要な異常をどう分けるか」を、ツール導入と同時に決めておきます。
コピペで使えるプロンプト例(通知ルールのたたき台作成):
当社は〇〇業、サーバー〇台・主要システムは〇〇です。
夜間・休日にシステム異常が発生した場合の通知・一次対応ルールを
簡潔な箇条書きで作ってください。

・どんな異常なら即対応が必要か(例:全断、決済不可 など)
・どんな異常なら翌営業日でよいか
・通知を受けた人が最初にすること
・エスカレーション先(連絡がつかない場合の次の連絡先)
つまずきやすいポイントと回避策
いきなり多機能な監視ツールを契約し、費用が想定より膨らむ → まずはクラウド標準の機能や無料枠から始め、足りない部分だけを有料オプションで足していくのが安全です。
アラートを全部「即対応」にしてしまい、通知疲れで無視するようになる → 影響の大きさで優先度を分け、軽微な異常は日次でまとめて確認する運用にします。
導入して終わりで、誰が対応するか決まっていない → ツールの設定と同時に、一次対応者・エスカレーション先を必ず決めておきます。
自走では越えにくい境界線
上記の方法で、「主要なサーバー・サービスの異常に人がすぐ気づける状態」は自社で作れます。一方、次の領域は専門的な設計が必要になります。
複数システム・複数拠点を横断した本格的な監視基盤の構築
扱うシステムが増え、ログ・APM・インフラ監視を一元化したい段階になると、Datadog・New Relicのような多機能プラットフォームが選択肢になりますが、料金体系が複雑で、どの機能をどこまで使うかの設計を誤ると費用が想定以上に膨らみます。専任の運用担当がいない場合は特に慎重な設計が要ります。
異常検知の精度チューニング
「いつもと違う」の基準をどう調整するか、誤検知(本当は正常なのにアラートが鳴る)をどう減らすかは、システムの特性を踏まえた継続的な調整が必要な領域です。
障害発生時の復旧手順そのものの整備
異常に気づけても、誰が何をすれば復旧するかの手順が整っていなければ被害は止まりません。これは監視の話とは別に、復旧手順書の整備という設計の話になります。
今週からできる、最初の一歩
今日試せることが1つあります。
いま契約しているクラウドの管理画面を開き、「モニタリング」「アラート」の項目があるか確認してください。設定できそうなら、まずは1つだけ——「サーバーが応答しなくなったら通知する」というシンプルなアラートを作ってみましょう。
クラウドを使っていない、または自社サーバーが中心という場合は、Mackerelの無料プランに主要なサーバーを1台だけ登録してみるところから始められます。
本記事で紹介したツールの機能・料金は2026年8月時点のものです。各社の仕様変更により変わる場合があります。導入前に各社の公式サイトで最新情報をご確認ください。